민감 속성이 여럿일 때, 한 번에 하나씩 나눠 맞춘다
Dividing and Fair Sampling: Fair Video Interview Assessment with Multiple Sensitive Attributes via Wasserstein Distance
- 논문
- Dividing and Fair Sampling: Fair Video Interview Assessment with Multiple Sensitive Attributes via Wasserstein Distance
- 저자
- Georu Lee, Jinho Choi, Seunghyeon Jung, Changwoo Kim, Jihyeong Yoo, Daehun Yoo, Woojin Lee** 교신저자
- 저널
- Engineering Applications of Artificial Intelligence (Elsevier)
- 지표
- SCIE, JCR Q1, JCR Top 3.35% (6/179)JCR 2025 · Engineering, Multidisciplinary
- 상태
- 2026년 10월 19일 게재 승인, 출판 진행 중
배경
자동화된 비디오 면접 평가 시스템은 지원자의 영상, 음성, 답변 텍스트를 함께 입력받아 채용 추천 점수를 예측합니다. 채용 결정에 영향을 주는 만큼 성별, 나이, 인종 같은 민감 속성에 대해 공정해야 합니다. 그러나 지금까지의 공정성 기법은 대부분 민감 속성 하나만 다뤘습니다. 연구실의 이전 연구(Kim et al., IEEE Access 2023)도 이진 민감 속성 하나로 나뉜 두 집단의 예측 분포 사이 Wasserstein distance 를 줄이는 방식이었습니다.
민감 속성을 여러 개 함께 고려하면 문제가 두 가지 생깁니다. 첫째, 교차 하위 집단의 수가 빠르게 늘어납니다. 이진 속성 3개면 하위 집단 8개, 비교할 쌍 28개이고, 4개면 하위 집단 16개, 쌍 120개입니다. 둘째, 일부 집단의 표본이 극히 적어집니다. First Impressions 데이터에서 성별·나이·인종을 함께 보면 가장 작은 집단(Male / Young / Non-Caucasian)은 전체의 0.79%, 가장 큰 집단(Female / Old / Caucasian)은 35.55%로 약 45배 차이가 납니다.
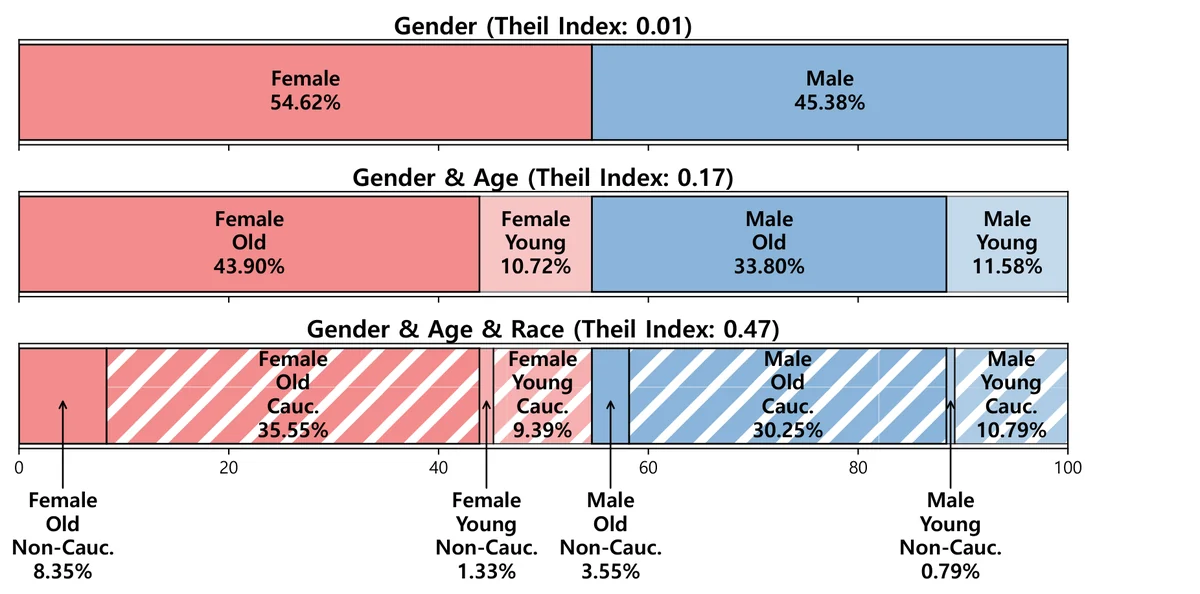
속성마다 따로 공정성을 확인하는 것만으로는 부족합니다. 성별로 나눠 봐도, 나이로 나눠 봐도 합격률이 비슷한데 젊은 여성 지원자 집단만 합격률이 낮은 경우가 있을 수 있습니다. 논문은 이 현상을 fairness-gerrymandering 으로 설명합니다.
제안 방법
자동화된 비디오 면접 평가에서 여러 민감 속성에 대한 공정성을 어떻게 높이고, 공정성과 예측 정확도 사이의 trade-off 를 어떻게 관리할 것인가
Dividing and Fair Sampling(DNF)은 매 학습 반복마다 민감 속성 하나를 골라 그 값에 따라 mini-batch 를 두 개의 sub-batch 로 나눕니다(Dividing). 예를 들어 성별을 고르면 여성 sub-batch 와 남성 sub-batch 가 만들어집니다.
이어서 Fair Sampling 이 각 sub-batch 안에서 나머지 속성들로 이루어진 하위 집단의 비율을 under-sampling 과 over-sampling 으로 다시 맞추고, 두 sub-batch 의 크기를 같게 만듭니다. 크기가 같은 1차원 경험분포끼리는 1-Wasserstein distance 를 간단한 닫힌 식으로 계산할 수 있습니다. DNF 는 이 거리를 정규화 항으로 MSE 손실에 더해, 두 sub-batch 의 예측 분포가 가까워지도록 학습합니다.
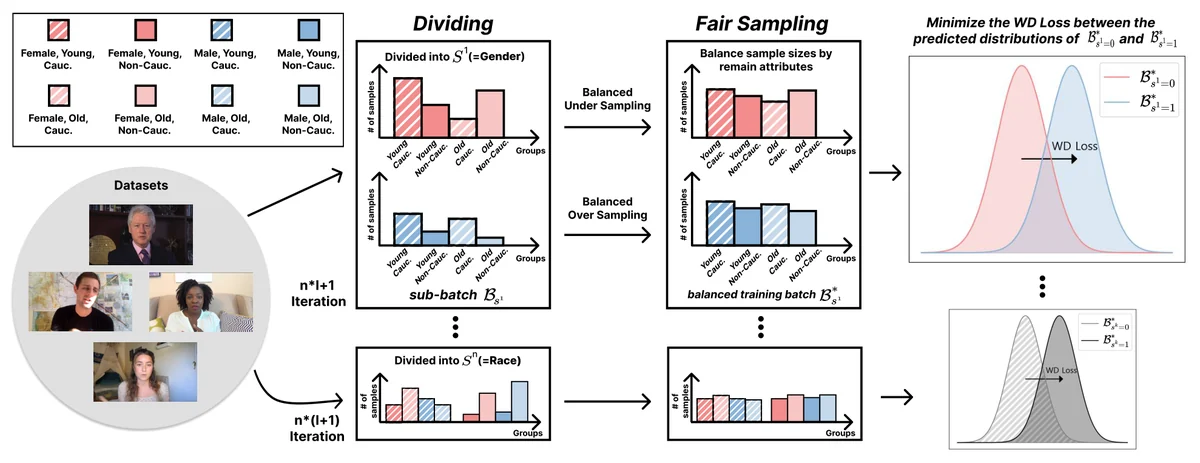
고르는 속성은 반복마다 순서대로 바뀝니다. 한 번에 속성 하나만 다루므로 모든 교차 하위 집단 쌍의 거리를 계산할 필요가 없고, Fair Sampling 이 표본이 적은 집단의 불균형을 덜어 줍니다.
실험 설정
- 데이터
- HR: 실제 채용 과정에서 수집한 한국어 면접 영상 5,862개(in-house). 경력 20년 이상 면접 전문가 3명의 평균 점수를 정답으로 사용. 민감 속성은 성별, 나이(30세 기준), 안경 착용 여부. FI: First Impressions 의 YouTube 클립 10,000개, 면접 초대 점수 예측. 민감 속성은 성별, 나이(25세 기준), 인종
- 모델
- 영상(2D CNN + LSTM), 음성(linear + LSTM), 텍스트(사전학습 BERT) 특징을 이어 붙인 멀티모달 회귀 모델
- 비교군
- Vanilla, MultiFair(Distance, Interp), Adv, FCRO, FSCL, FairICP
- 지표
- 예측 성능은 Pearson correlation coefficient(PCC). 공정성은 threshold 에 의존하지 않는 SPDD, SPEOP 의 평균값(mean)과 최댓값(max)
결과
- HR 데이터에서 DNF 는 SPDD_mean 0.025, SPEOP_mean 0.021, SPEOP_max 0.218 로 비교군 가운데 가장 낮았습니다. Vanilla 는 각각 0.075, 0.076, 0.410 이었습니다. SPDD_max 는 FSCL(0.155)이 DNF(0.162)보다 조금 낮았습니다.
- FI 데이터에서도 SPDD_mean 0.017, SPEOP_mean 0.026, SPEOP_max 0.266 으로 가장 낮았고, SPDD_max 는 FCRO(0.124)가 DNF(0.131)보다 낮았습니다. Benjamini-Hochberg 보정을 적용한 짝비교에서 DNF 는 HR 의 공정성 비교 28건 중 23건, FI 의 28건 중 20건에서 유의하게 낮은 격차를 보였고, DNF 보다 유의하게 공정한 비교군은 없었습니다.
- 공정성을 얻은 대신 예측 성능은 내려갔습니다. PCC 는 Vanilla 대비 HR 에서 0.525 에서 0.452 로, FI 에서 0.631 에서 0.577 로 낮아져 각각 약 13.9%, 8.6% 감소했습니다. 이 균형은 WD 가중치 λw 로 조절할 수 있어, λw 를 줄이면 예측 성능이, 키우면 공정성이 좋아졌습니다. 비교군 중 이런 단조로운 관계를 보인 것은 FairICP 뿐이었습니다.
- 추가 계산 비용은 작았습니다. NVIDIA H200 한 장에서 FI 기준 epoch 당 학습 시간은 56초로 Vanilla(54초)의 1.04배였고, FSCL 은 9.35배, FairICP 는 2.00배였습니다. 얼굴 이미지 데이터인 CelebA 에서도 네 가지 공정성 지표가 모두 가장 낮았고, SPDD_max 는 Vanilla 의 0.442 에서 0.290 으로 줄었습니다.
의의
채용처럼 판단이 사람의 기회와 직결되는 분야에서는 성별, 나이, 인종을 함께 따져야 하고, 그때 교차 집단의 수와 표본 부족이 걸림돌이 됩니다. DNF 는 속성을 하나씩 돌아가며 다루고 표본 비율을 맞추는 방식으로 두 문제를 적은 계산 비용으로 다루며, 공정성과 예측 성능의 균형을 λw 하나로 조절할 수 있게 했습니다. 논문은 이 방법이 채용 결정의 유일한 근거가 되어서는 안 되며 사람의 검토가 함께 필요하다는 점도 밝히고 있습니다.